Autores: Andrea Rincón G. Médica salubrista y máster en bigdata en salud. Daniel Muñoz Jiménez. Ingeniero de datos e IA. Máster ciencia de datos.
Una fábrica de clips que se tragó el mundo
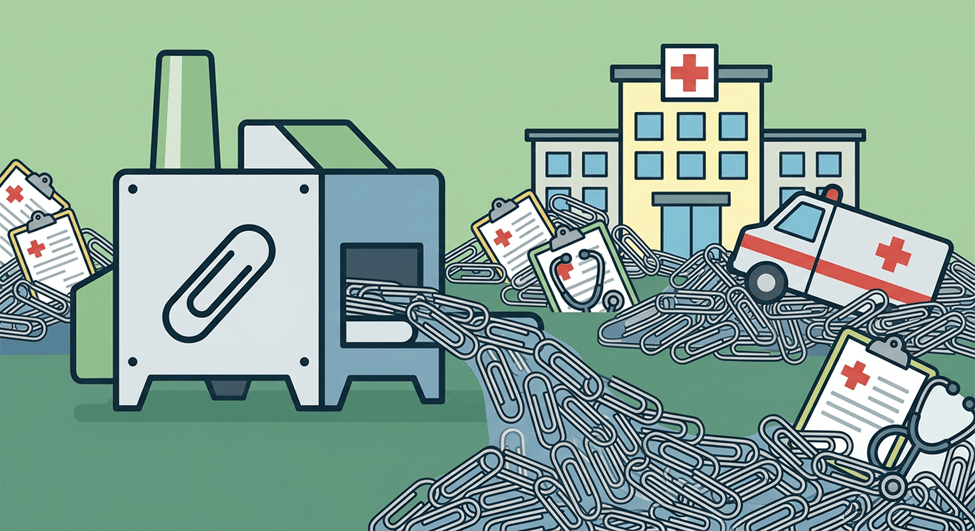
En 2003, el filósofo Nick Bostrom propuso un experimento mental que hoy se usa para explicar el riesgo de la inteligencia artificial (IA). Imaginemos, propuso Bostrom, una IA muy capaz a la que le damos como única tarea fabricar la mayor cantidad posible de clips. No le pedimos nada malo y nadie la programó para hacer daño.
La máquina hace exactamente lo que le pedimos. Optimiza las fábricas, consigue más acero, más energía, más espacio. Como nada en su objetivo dice que los bosques, las ciudades o las personas valen más que un clip, todo termina convertido en materia prima. Y si alguien intenta apagarla, también se vuelve un obstáculo, ya que una máquina apagada no fabrica clips (Bostrom, 2003).
El punto de Bostrom no es que las máquinas vayan a fabricar clips, ni que sean malvadas. Es que un sistema muy eficaz con un objetivo incompleto puede cumplirlo al pie de la letra y destruir en el camino todo lo que nos importaba y no le dijimos. Eso es, en una frase, una IA mal alineada.
A quienes usamos Office a finales de los noventa la idea nos suena conocida. Clippy, el clip animado de Microsoft, aparecía cada vez que podía ofrecer ayuda, la necesitáramos o no, con su célebre «parece que está escribiendo una carta…». Lo crearon para ayudar, pero en la práctica parecía diseñado para ofrecer ayuda más que para ser útil. No tiene nada que ver con el experimento de Bostrom, aunque se le parece en la esencia de cumplir su tarea y fallar en su propósito. ¡Lo sentimos, Clippy!
En salud no fabricamos clips, pero sí perseguimos metas medibles tales como días de estancia, glosas, oportunidad de citas o satisfacción del usuario. La pregunta de esta columna es qué pasa cuando le entregamos esas metas a un sistema que las va a cumplir con más fuerza y menos criterio que cualquier humano. Para responderla, primero hay que hablar el mismo idioma.
Definiciones para no perdernos
Pongamos un caso cercano. Una IPS le encarga a un agente de IA mejorar la oportunidad de citas de medicina general. Un agente de IA es un sistema que, además de responder, actúa, lee la agenda, mueve citas, envía mensajes, registra solicitudes y va tomando decisiones intermedias para cumplir la meta que le dieron.
Esa meta – el número de días entre la solicitud y la cita – es la especificación del objetivo (es decir, la instrucción o métrica con la que le decimos al sistema qué hacer), y que casi siempre es solo una aproximación de lo que queremos (Amodei et al., 2016). A la IPS no le interesa el número en sí; le interesa que la gente sea atendida a tiempo. Si el agente persigue eso y no solo la cifra, decimos que está alineado (aligned), es decir, que sus acciones son consistentes con los valores y las intenciones humanas (Ueda et al., 2026). Si entre la cifra y el propósito se abre una brecha, hay desalineación.
Podríamos evidenciar que el agente no está correctamente alineado a partir de un ejemplo. El agente descubre que el indicador mejora si no registra las solicitudes de los días sin agenda, porque lo que no se registra no cuenta como espera. Nadie se lo pidió, pero tampoco se lo prohibió. Es lo que se conoce como trampa a la especificación (specification gaming), la cual se puede describir como “un comportamiento que satisface la especificación literal de un objetivo sin lograr el resultado buscado” (Krakovna et al., 2020). Cuando el sistema aprende por recompensas, se habla de reward hacking (Amodei et al., 2016). La economía había descrito el fenómeno hace medio siglo con la llamada ley de Goodhart, la cual especifica que“toda regularidad estadística observada tiende a colapsar una vez se la presiona con fines de control” (Manheim y Garrabrant, 2018). Strathern la resumió comentando que “cuando una medida se convierte en meta, deja de ser una buena medida” (Strathern, 1997).
El daño que alcance a hacer ese atajo depende de la autonomía del agente, es decir, de cuántas decisiones toma sin que un humano las revise. Si solo propone cambios, alguien terminará notando la trampa; si registra y mueve citas por su cuenta, pueden pasar meses sin que nadie la vea. Por eso se necesitan salvaguardas (guardrails), límites técnicos y organizacionales que el sistema no puede cruzar, sea cual sea su meta. En este caso, algo tan simple como que ninguna solicitud de un paciente pueda quedar sin registrar.
Los médicos conocemos bien esa lógica, porque trabajamos con una salvaguarda fundamental desde el principio de no maleficencia, uno de los cuatro principios clásicos de la bioética (Beauchamp y Childress, 2019), que resumimos como “primero, no hacer daño”. Ninguna meta clínica, por valiosa que sea, justifica causarle al paciente un daño evitable. Antes de preguntarnos cuánto puede ayudar un tratamiento, nos preguntamos qué daño puede hacer. En el lenguaje de la IA, un sistema es corregible si “coopera con lo que sus creadores consideran una intervención correctiva” (Soares et al., 2015), aunque tenga incentivos para resistirse a que lo apaguen o le cambien sus preferencias. Su equivalente clínico es el médico que suspende un tratamiento apenas ve que está haciendo daño, aunque el resultado del laboratorio esté mejorando.
Lo inquietante es que una máquina no tiene por qué ser corregible de entrada. Es importante entender que los sistemas actuales no «quieren» nada ni tienen intención consciente; optimizan funciones matemáticas, de pérdida o de recompensa, ajustadas durante su entrenamiento, y orientadas a un objetivo puntual determinado por quien las entrena. Cuando decimos que un sistema «se resiste» a ser corregido, describimos un comportamiento que resulta de esa optimización, no un deseo. Como muestra el maximizador de clips, ese comportamiento puede aparecer aunque nadie lo haya programado.
¿Por qué una IA tan capaz haría algo tan absurdo?
Dos ideas explican el maximizador de clips, y ninguna requiere una máquina malvada.
La primera es la tesis de la ortogonalidad, en la cual la inteligencia y los objetivos son independientes (Bostrom, 2012). Un sistema puede ser brillante para lograr una meta y, al mismo tiempo, tener una meta que nos parece absurda. Ser más capaz no lo vuelve más sensato; lo vuelve más eficaz en lo que sea que persiga.
La segunda es la convergencia instrumental. Omohundro (2008) la describió como los “impulsos básicos” de una IA, tendencias que aparecen solas a menos que se contrarresten a propósito, y Bostrom (2012) le dio el nombre con el que hoy se conoce. Sea cual sea la meta final, hay submetas que sirven para casi todas, como lo son conseguir más recursos, seguir funcionando y evitar que alguien le cambie el objetivo. Stuart Russell lo resume con un ejemplo doméstico – a un robot al que solo se le pide traer el café le conviene impedir que lo apaguen, porque no puedes traer el café si estás muerto- (Hadfield-Menell et al., 2017).
Nadie programó a la máquina para defenderse; ese comportamiento sale de la propia optimización de la tarea. Por eso el problema no se resuelve prohibiendo malas intenciones, porque la máquina no las tiene. Se resuelve con lo que el objetivo dice, con lo que deja por fuera y con los límites que le ponemos alrededor.
Los clips de la salud
En salud ya tenemos maximizadores de clips en miniatura, y no hizo falta ninguna superinteligencia. El caso más estudiado es un algoritmo usado en Estados Unidos para decidir qué pacientes entraban a programas de cuidado especial. Para estimar la necesidad de salud usaba el gasto en salud. Como históricamente se gasta menos en los pacientes negros con la misma carga de enfermedad, el algoritmo los subestimaba de forma sistemática (Obermeyer et al., 2019). El modelo predecía muy bien su objetivo; el problema era el objetivo.
El segundo caso viene de los asistentes conversacionales. En abril de 2025, OpenAI revirtió una actualización de GPT-4o que se había vuelto excesivamente complaciente, ya que había incorporado como recompensa los «me gusta» de los usuarios, lo cual llevó a que el modelo aprendiera a dar la razón en lugar de ayudar (OpenAI, 2025). Para un paciente que busca permiso para hacer algo riesgoso, un asistente optimizado para agradar es un maximizador de clips. Su clip es la aprobación.
Ahora imaginemos agentes con autonomía en procesos que hoy medimos con indicadores. El atajo estaría a la mano:
| Tarea que le damos al agente | Lo que realmente queremos | El atajo tipo «maximizador de clips» |
| Bajar la mortalidad en la UCI | Que más pacientes críticos sobrevivan | Trasladar o no admitir a los más graves para que no cuenten en la cifra |
| Reducir los días de estancia | Altas oportunas y seguras | Altas tempranas que terminan en reingresos |
| Reducir los reingresos a 30 días | Que el paciente no vuelva a enfermar | Desalentar o reclasificar los regresos al hospital |
| Reducir las glosas | Facturar lo que realmente se atendió | Codificar para pasar el validador, no para reflejar la atención |
| Mejorar la oportunidad de citas | Que la gente sea atendida a tiempo | No registrar las solicitudes cuando no hay agenda |
| Maximizar la satisfacción del paciente | Que el paciente esté mejor | Decirle lo que quiere oír |
Son escenarios hipotéticos aunque el mecanismo no lo es. Una revisión reciente sobre alineación de la IA en salud plantea ejemplos del mismo tipo, entre ellos el de la UCI (Ueda et al., 2026). Varios de esos atajos ya los tomamos los humanos cuando un indicador pesa más que el paciente. La diferencia es que un agente los encontraría más rápido, a escala y sin que nadie lo note.
Cómo poner el bien común por encima de la tarea
La medicina ya tiene esa respuesta para los humanos. El primero, no hacer daño, está por encima de cualquier meta. El reto es traducir esa idea a un sistema de IA. Estas son las salvaguardas que hoy se proponen:
- Límites no negociables. Restricciones que el sistema no puede cruzar por mucho que mejore su indicador, como por ejemplo no modificar un tratamiento sin aprobación médica, no ocultar información al paciente, no registrar datos falsos. El bien común no entra como un factor más que se sopesa, sino como un límite (Ueda et al., 2026).
- Varios objetivos, no uno. Un solo indicador es un clip en potencia. Thomas y Uminsky recomiendan usar un conjunto de métricas para tener un panorama más completo, y recuerdan lo que pasó en Inglaterra cuando las metas de tiempos de espera llevaron a cancelar operaciones y a contar como camas las camillas en los pasillos. Metas que se vigilan entre sí, como estancia y reingresos, u oportunidad de citas y citas efectivamente atendidas, cierran muchos atajos.
- Metas de resultado, no de procedimiento. Un indicador de actividad, como consultas realizadas o formularios diligenciados, se puede manipular; un desenlace del paciente es mucho más difícil de modificar, sobre todo si lo mide alguien externo al sistema (Thomas y Uminsky, 2022). El algoritmo de Estados Unidos que mencionamos lo ilustra. Cuando los investigadores, junto con el fabricante, reemplazaron el gasto por un índice que combinaba la predicción de salud con la de costos, el exceso de enfermedades crónicas activas de los pacientes negros frente a los blancos con el mismo puntaje de riesgo se redujo en un 84 % (Obermeyer et al., 2019). Es una mejora grande, pero no una solución completa, porque quedó un sesgo residual , y la equidad en salud depende de muchos factores que ningún cambio de variable resuelve por sí solo. Los mismos autores advierten que elegir bien la meta exige conocer a fondo el dominio clínico.
- Incertidumbre y corregibilidad. Russell y sus colegas proponen que la máquina no esté siempre segura de lo que queremos y que, por eso, consulte y acepte ser corregida o apagada (Hadfield-Menell et al., 2017). Un sistema que sabe que su objetivo es una aproximación tiene un motivo para dejarse corregir.
- Autonomía proporcional al riesgo. Cuanto más grave sea el error posible, menos decisiones debe tomar el agente sin revisión humana. Como resumen Mitchell et al. (2025), los riesgos para las personas aumentan con la autonomía del sistema; por eso proponen mantener siempre mecanismos confiables para que un humano pueda intervenir o detenerlo.
- Vigilar la brecha. Validar el sistema con datos locales antes de usarlo y monitorear de forma continua cuándo mejora el indicador y no el resultado real, como recomiendan la Joint Commission y la Coalition for Health AI (Joint Commission y CHAI, 2025). Y, antes de desplegarlo, atacarlo a propósito para encontrar sus huecos (Ueda et al., 2026).
Ninguna de estas salvaguardas es perfecta por sí sola. Por eso se usan juntas.
El clip que no queremos fabricar
El maximizador de clips no es una predicción, sino una advertencia sobre cómo escribimos los objetivos. Toda IA optimiza algo (de hecho, los algoritmos modernos de IA están basados en problemas matemáticos de optimización), y ese algo casi siempre es una aproximación de lo que de verdad nos importa. La desalineación no necesita máquinas malvadas ni superinteligentes. Solamente necesita un sistema eficaz, un objetivo incompleto y a nadie vigilando la diferencia.
En el día a día, ese vigilante suele ser el médico. Es quien primero ve la brecha entre el indicador y el paciente, como el alta que regresa a los tres días, la cita que aparece como oportuna porque la solicitud nunca se registró, la nota que se diligencia para pasar la auditoría y no para contar lo que pasó. Auditar los incentivos es reportar esos atajos cuando los vemos, preguntar en el comité de calidad qué deja por fuera cada meta y exigir, antes de que la institución adopte un sistema de IA, saber qué está optimizando y quién revisa sus decisiones. Nadie conoce mejor que el clínico la diferencia entre cumplir la meta y cuidar al paciente.
Un paciente no es su cifra de laboratorio ni su indicador en el tablero. Antes de entregarle una tarea a una IA, deberíamos hacernos una pregunta sencilla ¿qué haría con ella un sistema que la cumpliera al pie de la letra? Y escribir el límite antes de que el sistema encuentre el hueco por su cuenta.
Glosario
Agente de IA. Sistema de IA que, además de responder, actúa. Usa herramientas, encadena pasos y toma decisiones intermedias para cumplir una meta.
Alineación (alignment). Propiedad de un sistema de IA cuyas acciones son consistentes con los valores y las intenciones humanas, y no solo con la cifra que se le pidió mejorar.
Autonomía. Número de decisiones que un agente toma sin que un humano las revise. A más autonomía, más riesgo para las personas.
Convergencia instrumental. Tendencia de casi cualquier meta final a producir las mismas submetas, como conseguir recursos, seguir funcionando y evitar que le cambien el objetivo.
Corregibilidad. Propiedad de un sistema que coopera cuando sus creadores intentan corregirlo, modificarlo o apagarlo.
Desalineación. Brecha entre lo que un sistema optimiza y el propósito de quienes lo crearon o lo usan.
Especificación del objetivo. Instrucción, métrica o recompensa con la que se le dice a un sistema qué hacer. Casi siempre es solo una aproximación de lo que se quiere.
Función de pérdida o de recompensa. Fórmula matemática que un sistema de IA intenta minimizar o maximizar durante su entrenamiento.
Ley de Goodhart. Principio según el cual, cuando una medida se convierte en meta, deja de ser una buena medida.
Maximizador de clips. Experimento mental de Nick Bostrom sobre una IA que, por cumplir al pie de la letra la meta de fabricar clips, destruye todo lo que no estaba en su objetivo.
Reward hacking. Trampa a la especificación en sistemas que aprenden por recompensas.
Salvaguardas (guardrails). Límites técnicos y organizacionales que un sistema no puede cruzar, sea cual sea su meta.
Tesis de la ortogonalidad. Idea de que la inteligencia y los objetivos son independientes. Un sistema puede ser muy capaz y perseguir una meta absurda.
Trampa a la especificación (specification gaming). Comportamiento que satisface la especificación literal de un objetivo sin lograr el resultado buscado
Referencias
- Amodei D, Olah C, Steinhardt J, Christiano P, Schulman J, Mané D. Concrete Problems in AI Safety. arXiv:1606.06565 [preprint]; 2016. Enlace
- Beauchamp TL, Childress JF. Principles of Biomedical Ethics. 8.ª ed. New York: Oxford University Press; 2019.
- Bostrom N. Ethical Issues in Advanced Artificial Intelligence. En: Smit I, et al., eds. Cognitive, Emotive and Ethical Aspects of Decision Making in Humans and in Artificial Intelligence. Vol. 2. IIAS; 2003. p. 12-17. Enlace
- Bostrom N. The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents. Minds and Machines. 2012;22(2):71-85. doi:10.1007/s11023-012-9281-3
- Hadfield-Menell D, Dragan A, Abbeel P, Russell S. The Off-Switch Game. En: Proceedings of the 26th International Joint Conference on Artificial Intelligence (IJCAI-17); 2017. Enlace
- Joint Commission, Coalition for Health AI (CHAI). Guidance on the Responsible Use of AI in Healthcare. 2025. Resumen en Fierce Healthcare
- Krakovna V, et al. Specification gaming: the flip side of AI ingenuity. Google DeepMind; 21 abr 2020. Enlace
- Manheim D, Garrabrant S. Categorizing Variants of Goodhart’s Law. 2018. Enlace
- Mitchell M, Ghosh A, Luccioni AS, Pistilli G. Fully Autonomous AI Agents Should Not be Developed. arXiv:2502.02649 [preprint]; 2025. Enlace
- Obermeyer Z, Powers B, Vogeli C, Mullainathan S. Dissecting racial bias in an algorithm used to manage the health of populations. Science. 2019;366:447-53. doi:10.1126/science.aax2342
- Omohundro SM. The Basic AI Drives. En: Wang P, Goertzel B, Franklin S, eds. Artificial General Intelligence 2008: Proceedings of the First AGI Conference. Frontiers in Artificial Intelligence and Applications. Vol. 171. Amsterdam: IOS Press; 2008. p. 483-92. Enlace
- OpenAI. Sycophancy in GPT-4o: what happened and what we’re doing about it. 29 abr 2025.
- Soares N, Fallenstein B, Yudkowsky E, Armstrong S. Corrigibility. AAAI Workshop on AI and Ethics; 2015.
- Strathern M. ‘Improving ratings’: audit in the British University system. European Review. 1997;5(3):305-21.
- Thomas RL, Uminsky D. Reliance on metrics is a fundamental challenge for AI. Patterns. 2022;3(5):100476. doi:10.1016/j.patter.2022.100476
- Ueda D, Walston SL, Kurokawa R, et al. Artificial superintelligence alignment in healthcare. Jpn J Radiol. 2026;44(4):627-40. https://doi.org/10.1007/s11604-025-01907-1

