Autor: Ricardo A Peña MD PhD
Profesor Asociado – Facultad de Medicina y Ciencias de la Salud – Universidad de los Andes – Miembro fundador de AIpocrates
X / Instagram: @drricardopena
Cuando los modelos de IA generativa se popularizaron, en 2022, nos sorprendió su funcionalidad y potencial. Poco a poco palabras como centros de datos, entrenamiento de modelos de lenguaje, consumo de tokens, se volvieron parte de nuestro vocabulario. En paralelo nos enteramos de la enorme inversión en recursos (billones de dólares) necesaria para desplegar estos modelos de inteligencia artificial en la población. Cada uno de nosotros, o nuestras instituciones, se enfrentó a la decisión de pagar por consumo de los modelos, porque las suscripciones gratuitas permitían un acceso limitado a los modelos, y generalmente restringían el uso de modelos de frontera (los más avanzados y recientes). Aquellas personas o empresas que pagaron por suscripciones, notaron el gran impacto que un modelo de frontera podía tener en sus trabajos del día a día.
Estos modelos iniciales provenían principalmente de Estados Unidos y compañías como OpenAI (ChatGPT), Anthropic (Claude), y Google (Gemini). La arquitectura de los algoritmos, los detalles del entrenamiento, y las relaciones matemáticas (pesos) entre los componentes de la información que manejan estos modelos, no es completamente conocida. Para usar estos modelos, un usuario accede por medio de una interfaz, generalmente un chat, y se beneficia del modelo aunque no conozca el detalle de cómo funciona el sistema.
Pero en 2024 China nos sorprendió cuando liberó Deepseek, un modelo de alto rendimiento, de forma gratuita y parcialmente abierta. Aunque los detalles de entrenamiento no fueron compartidos, si se liberaron algunos componentes de la arquitectura y los pesos del modelo. Esto en lenguaje sencillo significa que una persona o institución con suficiente poder de cómputo puede correr el modelo en su propio hardware y ajustarlo a sus necesidades particulares. [1] Progresivamente la oferta de modelos de lenguaje chinos (abiertos y de bajo costo) se ha expandido con alternativas como Qwen (Alibaba), Kimi (Moonshot AI), Mimo (Xiaomi), GLM (Zhipu AI), Minimax (Minimax).
Esta estrategia cambio el paradigma de acceso a modelos avanzados de IA. Inicialmente los modelos Chinos iban por detrás de la capacidad de los modelos estadounidenses. Sin embargo, eran lo suficientemente buenos para muchas tareas del día a día. En la actualidad, los mejores modelos de China están acercándose al nivel de los modelos más avanzados de ChatGPT o Claude, e incluso los modelos de generación de imágenes y video Minimax H3, Seedance 2.0 (Bytedance) están ligeramente por delante. [2]
La pregunta que entonces muchos nos hemos hecho es ¿Por qué una empresa compartiría un modelo de inteligencia artificial que ha requerido recursos y conocimiento para desarrollarse?
Esta decisión empresarial permite entrar en una cuestión más amplia: ¿cómo intenta China convertir sus avances en IA en capacidades que se utilicen en toda la economía? Su estrategia combina orientación estatal, inversión en infraestructura y experimentación en empresas e instituciones. [3]
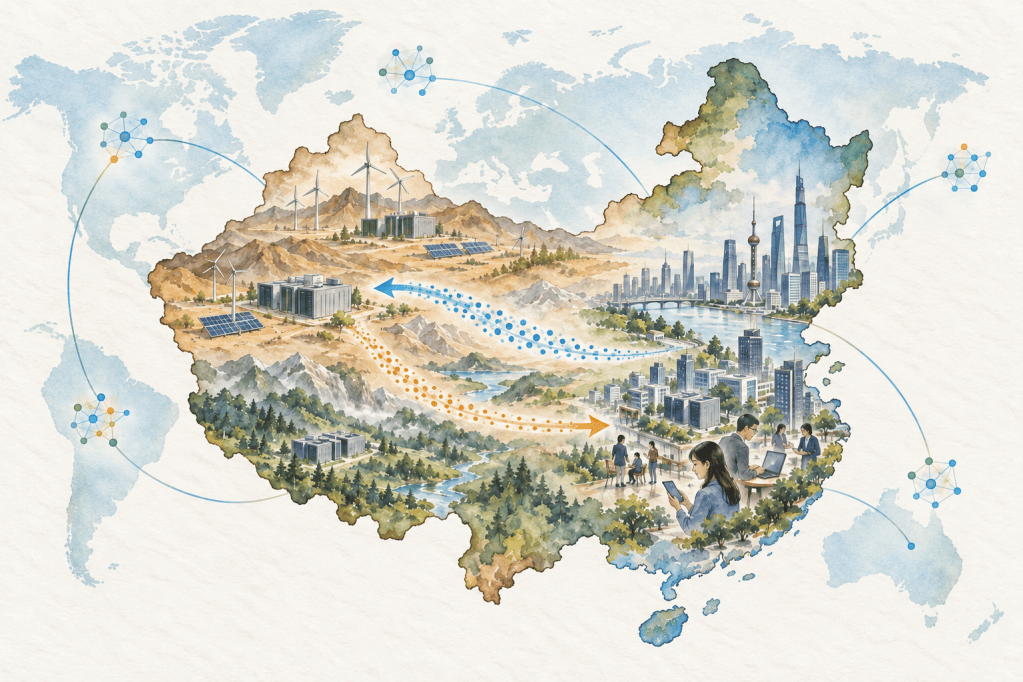
Figura 1. La estrategia China de la IA. China busca que el aprovechamiento de sus recursos naturales, capacidad humana e infraestructura le permita adaptar y liderar el desarrollo de modelos y aplicaciones de IA. Ilustración creada por el autor por medio de ChatGPT Image 2.
El plan de China hacia 2030 y la construcción de capacidades
El Plan de Desarrollo de Inteligencia Artificial de Nueva Generación, publicado en 2017, fijó un horizonte que llegaba hasta 2030. Su ambición reunía investigación, aplicaciones, formación, infraestructura y gobernanza. Incluía la transformación industrial y los servicios públicos, junto con defensa y seguridad nacional. Por tanto, se trataba de una política de desarrollo con múltiples instrumentos, cuyo alcance excedía la creación de productos informáticos. [3]
El plan organizó sus aspiraciones en tres etapas:
- 2020, alcanzar un nivel comparable al internacionalmente avanzado en tecnología y aplicaciones.
- 2025, generar avances importantes en la investigación básica y alcanzar una posición de liderazgo en algunas tecnologías y aplicaciones.
- 2030, convertir a China en un centro mundial de innovación en IA. [3]
La importancia de esa secuencia está en que conecta distintas capacidades. Incorporar herramientas disponibles puede resolver necesidades inmediatas; producir conocimiento y formar especialistas amplía las posibilidades de desarrollar soluciones propias. A su vez, una investigación prometedora necesita empresas e instituciones capaces de convertirla en productos y servicios. Una estrategia nacional debe ocuparse de las relaciones entre estos procesos, además de financiar cada uno por separado.
¿Cómo se traduce esa orientación en instrumentos? Las directrices de 2019 para la innovación abierta ofrecen un ejemplo. Promovieron iniciativas lideradas por empresas y colaboración con gobiernos locales, universidades y centros de investigación. Las iniciativas incluían compartir recursos técnicos, facilitar conjuntos de datos y herramientas, y apoyar aplicaciones de pequeñas y medianas empresas. [4] Entre los ámbitos identificados oficialmente figuraban la conducción autónoma con Baidu, la gestión urbana con Alibaba Cloud y las imágenes médicas con Tencent. [5]
La geografía del cómputo y la política de Este y Oeste en China
Antes de hablar de modelos, necesitamos entender la infraestructura física que los soporta. Un centro de datos reúne computadoras especializadas, equipos de almacenamiento y redes. Requiere electricidad continua, refrigeración y personal que mantenga la operación. Cuando utilizamos un servicio en la nube, nuestras solicitudes llegan a instalaciones físicas que conocemos como Centros de Datos (datacenters).
Para hacer un mejor uso de sus recursos geográficos e infraestructura tecnológica, China generó la política “Datos del Este (oriente), cómputo del oeste (Occidente)”. Esta política busca separar parcialmente dónde se consumen datos, de dónde se realiza su procesamiento. [6] Sus nodos son regiones que concentran centros de datos conectados por redes de alta velocidad:
- Al oriente Beijing, Tianjin, Hebei, Shanghái, Hong Kong, Macao atienden grandes concentraciones de usuarios;
- Al occidente Mongolia Interior, Guizhou, Gansu y Ningxia aprovechan mayor disponibilidad de suelo y fuentes de energía para recibir tareas trasladables, [7]
Así, una institución del oriente puede utilizar resultados calculados en servidores del occidente sin trasladar allí sus servicios. La separación depende del tiempo de respuesta necesario:
- almacenamiento, copias de seguridad y análisis, que pueden esperar, se desplazan con mayor facilidad;
- telemedicina y aplicaciones que requieren respuestas inmediatas conservan cómputo cercano al usuario. [6]
El proyecto permite apreciar una característica de la estrategia china: vincular desarrollo digital, energía y organización territorial. Su éxito requiere algo más que construir instalaciones. Hacen falta conexiones adecuadas, clientes que utilicen la capacidad y coordinación con el suministro eléctrico. [6] El costo relevante para una institución incluye el servicio completo, desde mover la información hasta mantener una operación confiable.
El camino al liderazgo: recursos y creatividad
El desarrollo de la IA requiere centros de datos equipados con GPUs, también conocidas como tarjetas de video y que son procesadores o chips especializados en realizar un gran volumen de cálculos simultáneos. La capacidad y memoria de las GPUs influyen en el tamaño de los modelos que pueden entrenarse, el tiempo necesario de entrenamiento y el costo de utilizarlos. Las GPUs más avanzadas son producidas por Nvidia, una compañía estadounidense. Para China, acceder a estos componentes se ha convertido en una dificultad estratégica: los controles anunciados por Estados Unidos en 2022 y ampliados en 2023 restringieron la exportación de determinados chips avanzados y equipos para fabricarlos, bajo argumentos de seguridad nacional. [8, 9] Estas medidas no eliminaron toda disponibilidad de procesadores, pero limitaron el acceso a parte de la tecnología de mayor capacidad y reforzaron la importancia de contar con alternativas.
En este contexto, la respuesta china combina desarrollar capacidad propia y aprovechar mejor los recursos disponibles. Empresas como Huawei impulsan procesadores Ascend y las herramientas de software necesarias para utilizarlos, porque sustituir un chip exige también adaptar los programas que trabajan con él. [10] Paralelamente, equipos como DeepSeek buscan reducir la demanda de procesamiento por medio de la optimización de las operaciones, la memoria y la comunicación entre procesadores que requieren sus modelos. Este caso muestra cómo la ingeniería puede mejorar el aprovechamiento del hardware; pero también recuerda que eficiencia y autonomía tecnológica son logros diferentes, pues ese entrenamiento todavía utilizó procesadores de Nvidia (Estados Unidos). [11]
Los modelos de frontera chinos: DeepSeek
DeepSeek permite observar cómo la búsqueda de eficiencia se traduce en modelos capaces de competir en tareas exigentes de lenguaje, programación y resolución de problemas. Para comprender su aporte conviene seguir dos lanzamientos relacionados: V3, que proporcionó una base de capacidades generales, y R1, que añadió entrenamiento orientado al razonamiento sobre esa base. [11, 12]
| Fecha | Suceso | Avance |
|---|---|---|
| 26 de diciembre de 2024 | Lanzamiento de DeepSeek V3 | Un modelo de propósito general que combinó desempeño competitivo, generado con técnicas para administrar y optimizar el cómputo. [1, 13] |
| 20 de enero de 2025 | Lanzamiento de DeepSeek R1 | Un modelo orientado al razonamiento, desarrollado a partir de V3 mediante etapas adicionales de entrenamiento. [12, 13] |
| 29 de enero de 2025 | Anuncio de R1 en Azure AI Foundry | Un ejemplo temprano de distribución por un proveedor internacional distinto del desarrollador. [14] |
Deepseek V3 fue el primer modelo de frontera Chino que alcanzó amplio reconocimiento mundial y podía utilizarse para tareas como generación de texto y programación. Su arquitectura contenía 671.000 millones de parámetros, pero la optimización consistió en mejorar el uso de memoria, modificar las técnicas de entrenamiento, y en usar una “mezcla de expertos” [11], por lo cual solo activaba aproximadamente 37.000 millones de parámetros por token. Esta diferencia ayuda a comprender la mezcla de expertos: el tamaño total del modelo y el trabajo realizado para cada tarea no son lo mismo.
DeepSeek R1 es un modelo orientado a resolver problemas de varios pasos, especialmente en matemáticas, programación y razonamiento lógico. Se desarrolló a partir de V3 Base. Su preparación combinó aprendizaje mediante ejemplos de soluciones con aprendizaje por refuerzo, que utiliza señales de recompensa. [12] DeepSeek R1 fue compartido por servicios de Microsoft Azure [14], lo cual facilitó su adopción rápida en la población de desarrolladores. Una segunda ventaja de este modelo de distribución, es que se podría generar una mayor sensación de confianza de la seguridad y utilidad del modelo, ante posibles prevenciones por su lugar de origen (China).
Abrir los modelos: una estrategia de posicionamiento
Para utilizar un modelo de inteligencia artificial a través de un servicio remoto, una institución envía sus consultas al proveedor y recibe respuestas. En ese caso la persona accede a la función, pero no tiene acceso a los archivos necesarios para ejecutar el sistema por su cuenta.
Cuando se publican los pesos de los modelos, la persona obtiene los valores que el modelo aprendió durante su entrenamiento que, junto con el software y la infraestructura adecuadas, permiten poner el modelo en funcionamiento. Publicar los pesos no significa que un usuario externo reciba el registro completo de los datos y decisiones utilizadas durante el entrenamiento. [15] Tener los pesos permite probar el comportamiento de una versión y, cuando la licencia de uso lo autoriza, adaptarla.
La licencia de uso establece qué pueden hacer otras personas u organizaciones con un modelo de IA: utilizarlo, adaptarlo, incorporarlo a un producto comercial o redistribuirlo. Por eso, descargar los pesos no significa que un usuario tenga permisos ilimitados sobre ellos. Las licencias permisivas, como MIT y Apache 2.0, conceden amplias posibilidades de reutilización bajo ciertas condiciones; [16, 17] otras licencias añaden restricciones sobre los usos permitidos o la distribución. El tipo de licencia influye en la capacidad de una universidad, empresa u hospital para adaptar un modelo y desarrollar aplicaciones propias.
| Modalidad | ¿Qué permite? | Condiciones principales y ejemplos |
|---|---|---|
| Permisiva: MIT | Usar, modificar y redistribuir el material, incluso dentro de productos comerciales, sin exigir que las modificaciones se publiquen. | Exige conservar el aviso de derechos de autor y la licencia. El modelo principal DeepSeek R1 publicó su código y sus pesos bajo MIT. [16, 18] |
| Permisiva: Apache 2.0 | También permite uso comercial, modificación y redistribución, sin obligar a publicar las modificaciones. | Exige conservar la licencia y los avisos pertinentes e identificar los archivos modificados. Incluye una autorización expresa sobre determinadas patentes de los contribuyentes. Se utiliza en varios modelos Qwen2.5. [17, 18] |
| Recíproca o copyleft: GPLv3 | Permite utilizar, modificar y comercializar software, pero busca mantener esas libertades en las versiones redistribuidas. | Al distribuir una versión modificada cubierta por GPLv3, debe conservarse esa licencia y facilitarse el código fuente correspondiente. Es un ejemplo del ámbito del software; no debe suponerse que aplica a los pesos de un modelo. [19] |
| Licencia propia con condiciones adicionales | Puede permitir descargar los pesos, modificarlos y utilizarlos comercialmente, dentro de los límites definidos por el desarrollador. | Llama 3.1, por ejemplo, exige atribución, cumplimiento de una política de usos aceptables y autorización adicional para organizaciones que superan un umbral de usuarios establecido en la licencia. El acceso a los pesos no elimina estas condiciones. [20] |
Controversias sobre los modelos de IA de China
La expansión internacional de los modelos chinos plantea preguntas que una comparación de capacidades técnicas no resuelve. ¿Cómo se obtuvieron los datos utilizados para entrenarlos? ¿Qué significa que un desarrollo haya sido “barato”? ¿Qué ganamos y qué responsabilidades asumimos al poder modificarlo? ¿Quién recibe nuestras consultas? Estas preguntas conectan la competencia tecnológica del desarrollo de los modelos, con la confianza necesaria para adoptar e implementar sus resultados.
- La destilación y la disputa por su uso
En IA, la destilación consiste en entrenar un modelo utilizando información producida por otro, con frecuencia más grande o capaz. Una modalidad emplea respuestas y ejemplos de resolución de problemas del modelo “maestro” para mejorar un modelo “estudiante”. [12] El objetivo es generar un modelo con parte del conocimiento del modelo maestro, pero con menor necesidad de cómputo.
La controversia aparece según las condiciones bajo las cuales se obtienen y utilizan las respuestas del modelo maestro. En febrero de 2026, Anthropic acusó a DeepSeek, Moonshot y MiniMax de realizar campañas para extraer capacidades de Claude mediante prácticas que, según la compañía, infringían sus condiciones de uso y restricciones de acceso. [21] En septiembre amplió sus denuncias sobre varios laboratorios chinos, incluido DeepSeek. [22]
El debate está relacionado con los incentivos para innovar y difundir conocimiento. Si las respuestas de un servicio permiten entrenar a un competidor, quien financió el modelo original tiene razones comerciales para limitar ese uso, o exigir una participación en las ganancias. Sin embargo, vale la pena recordar la discusión acerca de cómo los grandes modelos de frontera desarrollados por diversos países, han aprovechado la información disponible en internet, en prácticas que podrían atentar contra los derechos de autor, sin brindar un reconocimiento a los autores y curadores de la información. [23] Evaluar cada caso de uso de información para entrenar modelos de IA, exige conocer la procedencia de los datos, los permisos aplicables y las acciones que se toman a partir de los datos.
- La autonomía y los riesgos de los pesos abiertos
La publicación de los pesos, los valores numéricos aprendidos durante el entrenamiento, permite que terceros ejecuten y adapten un modelo con el software y la infraestructura adecuados, según las condiciones de su licencia. Esa posibilidad amplía la autonomía de quienes lo utilizan y facilita la validación externa de los modelos. Sin embargo, la publicación de los pesos también reduce el control del desarrollador sobre las modificaciones y los usos posteriores de un modelo., Así por ejemplo, un tercero puede alterar mecanismos destinados a restringir respuestas peligrosas.. [24]
- La privacidad de las consultas
La confianza también depende de dónde circulan los datos. Países como Colombia cuentan con políticas de protección de datos que restringen los permisos, usos y lugares donde se puede procesar y usar la información. [25] Quien evalúa la adopción de un modelo “abierto” de IA, debe considerar y verificar: quién recibe la información, dónde la almacena, para qué puede utilizarla y qué controles ofrece. El país y la empresa de origen de un servicio tecnológico es parte del contexto; identificar al operador y los flujos efectivos de datos permite evaluar la confiabilidad de un servicio o herramienta.
Lecciones para América Latina
Para tomadores de decisión y lideres de implementación de tecnología en América Latina conocer la geopolítica de la IA, las estrategias de países como China es una necesidad crítica. El Índice Latinoamericano de Inteligencia Artificial de 2025, elaborado por CENIA y CEPAL, identifica brechas de talento e inversión y dificultades para financiar y ejecutar estrategias nacionales en nuestra región. [26] Nuestro camino por lo tanto incluye dos rutas paralelas: la adopción de tecnologías extranjeras ,mientras avanzamos en la construcción de capacidades locales.
La experiencia china muestra el valor de conectar una estrategia y política de largo plazo con infraestructura, conocimiento técnico y organizaciones capaces de adoptar innovaciones. También muestra por qué conviene examinar nuestros modelos de innovación y evaluar la articulación de la famosa triple hélice: Gobierno, academia y empresa.
*Declaración de uso de IA. Para la redacción de esta columna se emplearon búsquedas profundas elaboradas con Gemini Flash 3.8 y ChatGPT Sol 6.1. Además, se emplearon agentes de revisión editorial y verificación de fuentes de información bajo ChatGPT 6 Astra. La imagen fue generada con ChatGPT Image 2. La inspiración original del documento y las ideas presentadas en el blog son responsabilidad del autor.
Referencias
Los títulos de los documentos oficiales chinos se presentan traducidos al español.
[1] DeepSeek-AI. DeepSeek-V3. Repositorio oficial y documentación técnica. Consultar fuente.
[2] Artificial Analysis. (s. f.). AA-Video-I2V v1.0: ranking de modelos de imagen a video con audio. Clasificación Elo basada en preferencias humanas; tabla dinámica consultada el 10 de octubre de 2026. Consultar fuente.
[3] Consejo de Estado de China. (2017). Plan de Desarrollo de Inteligencia Artificial de Nueva Generación. Consultar fuente.
[4] Ministerio de Ciencia y Tecnología de China. (2019). Directrices para la construcción de plataformas nacionales de innovación abierta en IA. Consultar fuente.
[5] Science and Technology Daily. (2019). Presentación de cinco plataformas nacionales de innovación abierta en IA. Reproducido por la Administración del Ciberespacio de China. Consultar fuente.
[6] Comisión Nacional de Desarrollo y Reforma. (2022). Preguntas y respuestas sobre el programa Datos del Este y cómputo del Oeste. Consultar fuente.
[7] Comisión Nacional de Desarrollo y Reforma. (2022). Entrevista sobre la puesta en marcha de Datos del Este y cómputo del Oeste y las funciones de los ocho nodos. 21 de marzo. Consultar fuente.
[8] Bureau of Industry and Security. (2022). Anuncio de controles de exportación sobre computación avanzada y fabricación de semiconductores. Consultar fuente.
[9] Bureau of Industry and Security. (2023, 17 de octubre). Commerce Strengthens Restrictions on Advanced Computing Semiconductors, Semiconductor Manufacturing Equipment, and Supercomputing Items to Countries of Concern. Consultar fuente.
[10] Huawei. (2025). Ascend: Open for All to Build a Vibrant Ecosystem. Comunicado sobre hardware y software Ascend en HUAWEI CONNECT 2025. Consultar fuente.
[11] DeepSeek-AI. (2024). DeepSeek-V3 Technical Report. arXiv:2412.19437, versión 1. Consultar fuente.
[12] DeepSeek-AI. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948, versión 1. Consultar fuente.
[13] DeepSeek. Registro oficial de cambios. Entradas del 26 de diciembre de 2024 y del 20 de enero de 2025. Consultar fuente.
[14] Microsoft. (2025). DeepSeek R1 is now available on Azure AI Foundry and GitHub. 29 de enero. Consultar fuente.
[15] Open Source Initiative. (2024). The Open Source AI Definition, versión 1.0. Consultar fuente.
[16] Open Source Initiative. (s. f.). The MIT License. Texto de la licencia. Consultar fuente.
[17] Apache Software Foundation. (2004). Apache License, Version 2.0. Secciones 2–4. Consultar fuente.
[18] DeepSeek-AI. DeepSeek-R1. Repositorio oficial, documentación y licencias. Consultar fuente.
[19] Open Source Initiative.. (2007). GNU General Public License, version 3. Secciones 5–6. Texto reproducido por Open Source Initiative. Consultar fuente.
[20] Meta. (2024, 23 de julio). Llama 3.1 Community License Agreement. Secciones 1–2. Consultar fuente.
[21] Anthropic. (2026, 23 de febrero). Detecting and preventing distillation attacks. Consultar fuente.
[22] Anthropic. (2026, 10 de septiembre). Detecting and countering misuse of AI: September 2026. Sección sobre destilación. Consultar fuente.
[23] U.S. Copyright Office. (2025, mayo). Copyright and Artificial Intelligence. Part 3: Generative AI Training. Versión de prepublicación; secciones III–V. Consultar fuente.
[24] National Telecommunications and Information Administration. (2024, julio). Dual-Use Foundation Models with Widely Available Model Weights. Informe de política. Consultar fuente.
[25] Congreso de Colombia. (2012). Ley Estatutaria 1581 de 2012, por la cual se dictan disposiciones generales para la protección de datos personales. Artículos 4, 9, 12 y 26. Texto en el Normograma de la Cancillería. Consultar fuente.
[26] CEPAL. (2025). América Latina y el Caribe acelera la adopción de la inteligencia artificial, aunque con desafíos en inversión, talento y gobernanza. Presentación del ILIA 2025. Consultar fuente.

