Autora: Dra. Alexandra Jiménez, Pediatra Intensivista, Magíster en IA
Durante décadas hemos defendido con vehemencia la autonomía médica frente a decisiones administrativas, presiones de la industria e intereses económicos. ¡Cuántas veces hemos exigido respeto por nuestro criterio clínico y nuestra independencia para decidir!
Pero esa misma firmeza parece diluirse cuando se trata de inteligencia artificial. Desde la llegada de ChatGPT en noviembre de 2022, expresiones como «Lo hice con IA» o «Eso lo hizo la IA» se han vuelto cada vez más cotidianas, incluso motivo de orgullo. ¿De qué autonomía estamos hablando si dejamos de cuestionar lo que hoy influye en nuestras decisiones?
Esta reflexión cobra especial relevancia ahora que Colombia busca establecer reglas para la inteligencia artificial en salud. El pasado 19 de octubre, la Comisión Séptima del Senado realizó una audiencia pública sobre el Proyecto de Ley 216 de 2026, que aborda su desarrollo, validación, implementación y vigilancia, con énfasis en la seguridad del paciente y la autonomía profesional. (1)
Pero si lo que está en juego es nuestro criterio clínico, los médicos no podemos ser espectadores de las decisiones que definirán cómo utilizaremos estas herramientas. Por eso resulta valioso el aporte de profesionales como Luis Eduardo Pino y Jaime González, vinculados a AIpocrates, quienes han impulsado esta conversación desde la medicina y no únicamente desde la tecnología.
Antes de definir las reglas, debemos preguntarnos qué estamos poniendo en manos de la inteligencia artificial. Hoy la usamos para redactar correos, mejorar textos o preparar presentaciones, pero también para interpretar imágenes médicas, predecir el deterioro de un paciente o sugerir tratamientos. Y no es lo mismo equivocarse en una diapositiva que en una decisión que puede cambiar una vida.
Ahí cobra sentido la regulación: no para frenar la innovación, sino para exigir seguridad y evidencia según el riesgo. En enero de 2026, la FDA actualizó su guía sobre los sistemas de apoyo a la decisión clínica (Clinical Decision Support, CDS), dejando una distinción clave: no basta con decir que una herramienta «apoya» al médico. Debemos poder comprender, evaluar y cuestionar sus recomendaciones. Porque apoyarnos en la tecnología no nos libera de la responsabilidad de decidir. (2)
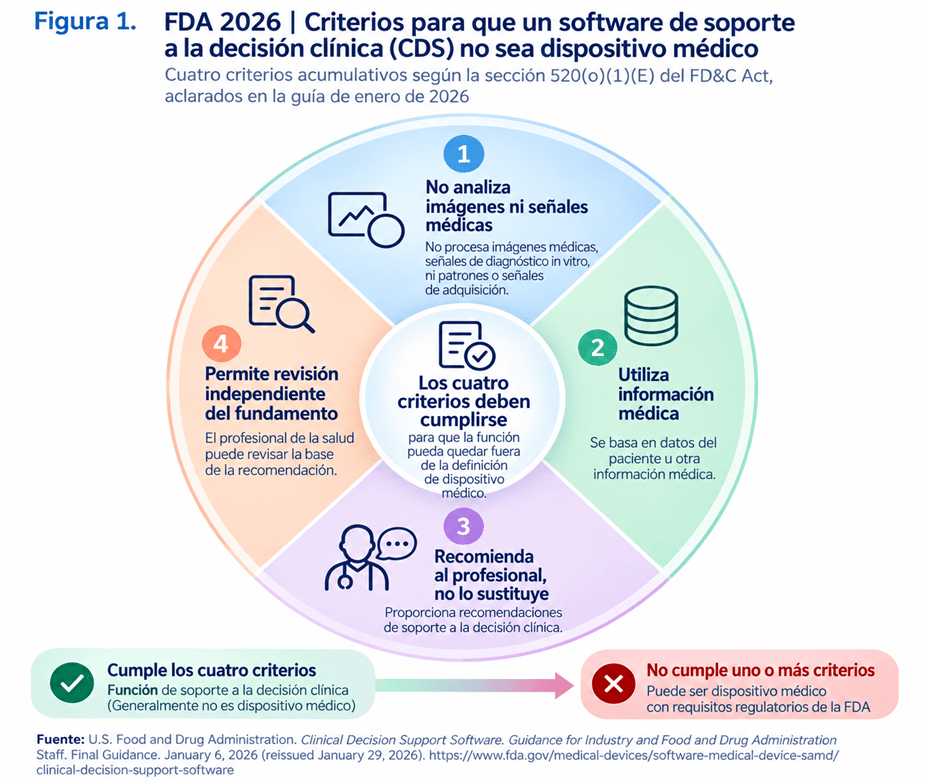
Pensemos en un paciente que llega a urgencias con fiebre. Una herramienta puede mostrarnos las recomendaciones de una guía clínica; otra, calcular su riesgo de sepsis; una tercera, sugerir iniciar antibióticos o trasladarlo a cuidados intensivos. Parecen formas de apoyo, pero no es lo mismo consultar información que recibir una recomendación capaz de cambiar el tratamiento.
Esa diferencia es esencial para entender el enfoque de la FDA. No todas estas herramientas están sujetas a las mismas exigencias: importa qué función cumplen, qué información procesan y si el médico puede revisar por sí mismo las razones de la recomendación. Cuanto mayor sea su influencia sobre la atención, más importante resulta conocer sus límites y comprobar que son seguras para el uso previsto. La guía de enero de 2026 aclara que la exclusión de determinadas funciones de soporte a la decisión clínica depende del cumplimiento conjunto de cuatro criterios legales; no cumplirlos no convierte automáticamente una función en dispositivo médico, pues también debe evaluarse su finalidad prevista.
Y aquí aparece un problema que ninguna norma resuelve por sí sola: ¿qué pasa cuando una herramienta parece funcionar muy bien, pero la evidencia que la respalda no es tan sólida como creemos?
La evidencia científica nos muestra por qué debemos hacernos esta pregunta. Un estudio publicado en Journal of Medical Internet Research (2026) identificó 1.430 dispositivos médicos con inteligencia artificial autorizados por la FDA hasta 2025. Más de la mitad fueron autorizados entre 2023 y 2025, principalmente en radiología.(3) La tecnología avanza rápidamente, pero contar con autorización no significa necesariamente haber demostrado mejores resultados para los pacientes.
El cambio también se siente en nuestra práctica diaria. Un estudio publicado en JAMA en octubre de 2026 documentó 271 millones de consultas a OpenEvidence por más de 950.000 profesionales de salud en Estados Unidos. Entre las preguntas de los médicos, el 33,1 % estaba relacionado con tratamientos y manejo clínico. Es una oportunidad extraordinaria para acercar el conocimiento científico a nuestras decisiones, pero estas cifras demuestran utilización, no beneficio clínico.(4)
Y cuando examinamos su desempeño, aparecen preguntas aún más importantes. Una revisión sistemática de 2026 evaluó modelos predictivos de Epic en 22 estudios, 34 centros y más de 2,3 millones de pacientes. El modelo de sepsis analizado alcanzó un AUROC de 0,65 y mostró variaciones entre instituciones.(5) Pensemos en una alerta que nos advierte sobre el riesgo de sepsis: ¿funcionaría igual en nuestros pacientes?, ¿cuántas falsas alarmas generaría?, ¿cambiaría realmente su pronóstico?
¿Qué sabemos realmente de los modelos en los que confiamos?
No debemos olvidar que identificar un riesgo no es lo mismo que demostrar que podemos evitarlo.Esta es precisamente una de las preocupaciones que ha planteado Leo Anthony Celi, médico e investigador del MIT, quien ha insistido en la necesidad de mirar más allá de la precisión de los algoritmos y preguntarnos por su verdadero impacto en la atención. Sus reflexiones ponen sobre la mesa cuatro desafíos científicos que no podemos ignorar al debatir la regulación de la inteligencia artificial en Colombia: los sesgos de los datos, la validación en nuestros pacientes, la diferencia entre predicción y beneficio clínico, y la calidad de la evidencia publicada.
1. Sesgos en los datos clínicos. Una historia clínica no refleja únicamente la enfermedad de un paciente; también registra las decisiones médicas, las barreras de acceso, las remisiones y las pruebas que pudieron realizarse. Una revisión de 116 estudios, en la que participó Leo Anthony Celi, identificó múltiples fuentes de sesgo en estos registros. Pensemos en un algoritmo entrenado con pacientes que tuvieron dificultades para acceder a determinados tratamientos o exámenes: podría interpretar esa ausencia de atención como una característica clínica, sin reconocer las barreras que la explican. En otras palabras, la inteligencia artificial puede aprender no solo cómo se comporta una enfermedad, sino también las desigualdades del sistema de salud donde fue entrenada. (6)
2. Validación externa y aplicabilidad local. Que un algoritmo funcione bien en el hospital donde fue desarrollado no significa que tenga el mismo desempeño en nuestros pacientes. La revisión de herramientas predictivas de Epic ya mencionada encontró diferencias importantes entre instituciones. Un modelo puede ser preciso en una población y perder confiabilidad al aplicarse en otra. Para Colombia, con realidades asistenciales tan diversas, esto es especialmente relevante. Y en pediatría, debemos ser aún más cuidadosos: no podemos asumir que una herramienta entrenada con adultos, o incluso con niños de otros contextos, sea igualmente válida para nuestros pacientes. Antes de confiar en sus resultados, necesitamos demostrar que funciona en la población donde vamos a utilizarla.(5)
3. Predicción frente a beneficio clínico. Un algoritmo puede identificar qué pacientes tienen mayor riesgo de complicarse, pero eso no significa que sepa qué intervención evitará esa complicación. Como advierte Leo Anthony Celi en sus trabajos sobre inteligencia artificial en medicina, encontrar asociaciones en los datos no equivale a demostrar relaciones de causa y efecto. Pensemos en una alerta que predice el deterioro de un paciente: puede ser estadísticamente precisa, pero su utilidad dependerá de que actuar sobre ella mejore realmente la atención. No basta con que la inteligencia artificial acierte en sus predicciones; necesitamos demostrar que las decisiones que tomamos a partir de ellas benefician al paciente.(7) Por eso, además de medir su precisión, debemos evaluar qué decisiones modifica, qué intervenciones desencadena y qué beneficios o daños produce su uso en condiciones reales.
4. Calidad de la evidencia científica. Los tres desafíos anteriores nos llevan a una pregunta inevitable: ¿qué tan sólida es la evidencia con la que estamos evaluando estas herramientas? Una revisión publicada en The BMJ en octubre de 2026 examinó 68 informes de ensayos clínicos sobre grandes modelos de lenguaje y encontró deficiencias en aspectos fundamentales para reproducir sus resultados y evaluar posibles daños. Si no conocemos con claridad cómo se estudió una herramienta, en qué pacientes se probó y cuáles son sus limitaciones, ¿cómo podemos decidir responsablemente si debemos incorporarla a nuestra práctica clínica? (8)
Conviene distinguir qué demuestra cada tipo de evidencia. Los estudios de utilización describen adopción, no efectividad; las evaluaciones retrospectivas permiten estimar desempeño, pero no sustituyen la validación prospectiva; y las revisiones o artículos de perspectiva identifican problemas relevantes sin probar, por sí solos, un beneficio clínico. Confundir estos niveles de evidencia puede llevarnos a confiar demasiado pronto en herramientas que influyen sobre decisiones de alto impacto.
Publicar un modelo no significa haber demostrado que está listo para incorporarse a la atención. Esa es una de las lecciones que nos dejan estos cuatro desafíos. La sofisticación tecnológica puede impresionar, pero no sustituye la evidencia clínica ni garantiza mejores resultados para los pacientes.
Colombia tiene hoy una oportunidad con el Proyecto de Ley 216 de 2026, que propone una regulación basada en riesgos y contempla la validación, supervisión, vigilancia y retiro de sistemas de inteligencia artificial en salud. La experiencia internacional ofrece referentes importantes: la FDA ha definido criterios específicos para determinadas funciones de soporte clínico y la Unión Europea ha adoptado un marco basado en riesgos. Pero no se trata de copiar modelos extranjeros, sino de construir la capacidad de evaluar estas tecnologías en las condiciones reales de nuestro sistema de salud. (1)
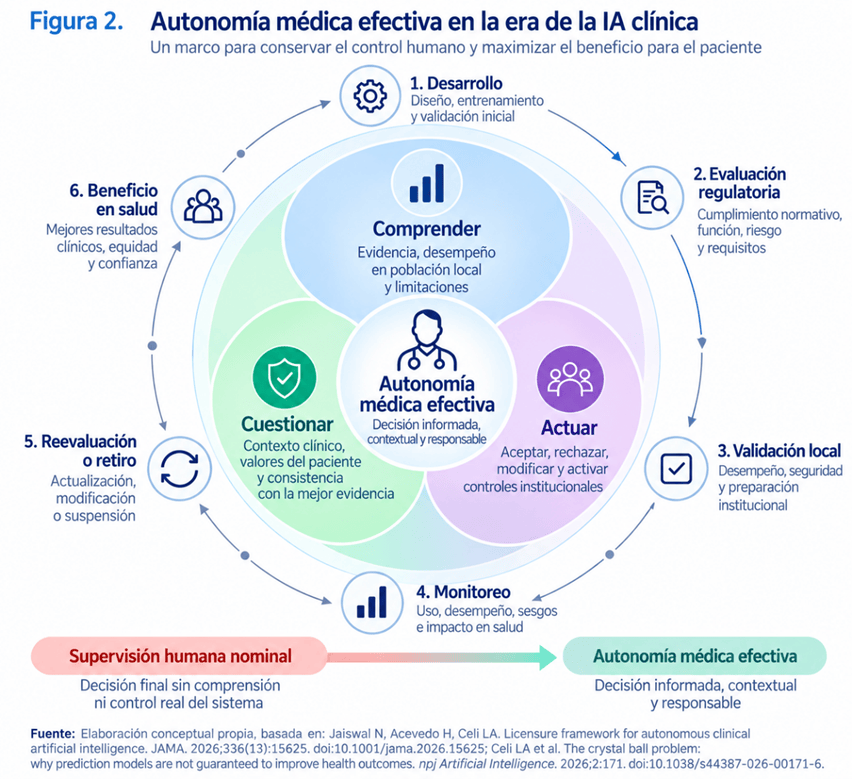
El human in the loop no puede ser solo una formalidad
Y aquí comienza un desafío que conocemos bien quienes trabajamos en hospitales. Una herramienta puede llegar con estudios publicados, resultados prometedores y respaldo comercial. Pero ¿quién verifica que funciona en nuestros pacientes? ¿Qué sucede cuando se actualiza o cambia su desempeño? ¿Quién identifica las recomendaciones inseguras y tiene la autoridad para suspender su uso?
La respuesta exige ir más allá de declarar que habrá supervisión humana. Necesitamos gobernanza clínica de la inteligencia artificial: evaluación independiente de la evidencia, validación proporcional al riesgo, seguimiento de su desempeño, trazabilidad de las decisiones y mecanismos para identificar incidentes y retirar herramientas cuando sea necesario. No son exigencias para frenar la innovación, sino condiciones para incorporarla responsablemente.
También debemos reconocer que esta responsabilidad no puede recaer exclusivamente sobre el médico que recibe una recomendación. Los desarrolladores, las instituciones y las autoridades tienen obligaciones diferentes, y los pacientes deben tener voz en decisiones que pueden afectar directamente su atención.
Quizás el cambio más importante sea comprender que un hospital no debería limitarse a adquirir inteligencia artificial; debería desarrollar la capacidad de evaluarla, vigilarla y cuestionarla. Así como exigimos competencias a los profesionales y evaluamos la seguridad de nuestras intervenciones, debemos preguntarnos qué evidencia respalda cada herramienta que incorporamos a la práctica.
Propongo que empecemos a distinguir entre autonomía médica formal y autonomía médica efectiva. La primera se conserva cuando el profesional sigue siendo quien toma la decisión final. La segunda exige comprender la evidencia que sustenta una recomendación, reconocer sus límites, contrastarla con el contexto del paciente y disponer de mecanismos institucionales para cuestionar su utilización. No basta con mantener al médico dentro del proceso si las condiciones para ejercer su juicio crítico se debilitan. ¿Estamos construyendo instituciones capaces de proteger esa autonomía o trasladando al profesional la responsabilidad de decisiones influidas por sistemas que no controla?
Durante años hemos reclamado que las decisiones sobre el ejercicio de la medicina cuenten con nuestra participación. La discusión legislativa actual nos ofrece una oportunidad concreta para ejercerla. No necesitamos que todos los médicos aprendan a programar. Sí necesitamos comprender qué hace una herramienta, qué evidencia sostiene sus recomendaciones y cuándo debemos dejar de confiar en ellas.
La autonomía médica no se pierde solamente cuando alguien nos impide decidir. También se debilita cuando dejamos de comprender qué está influyendo en nuestras decisiones.
Defenderla hoy exige pasar de la reflexión a la acción. Es momento de que las sociedades científicas, las universidades y las instituciones de salud asuman un papel activo en la evaluación y gobernanza de estas tecnologías. Y tú, ¿sabes qué herramientas de inteligencia artificial se utilizan en tu hospital, quién las evalúa y cómo se vigilan sus resultados? ¿Participas en esas decisiones o simplemente observas?
Declaración de uso de inteligencia artificial: Se utilizó inteligencia artificial como apoyo en la revisión editorial, la verificación de referencias bibliográficas y la elaboración de las figuras. Las ideas, el análisis y las conclusiones son de autoría propia.
Referencias bibliográficas
1. Senado de la República de Colombia. Comisión Séptima del Senado avanza en la regulación de la inteligencia artificial en salud. Bogotá D. C.; 19 de octubre de 2026. Audiencia pública sobre el Proyecto de Ley 216 de 2026 Senado. Disponible en: https://www.senado.gov.co/index.php/el-senado/noticias/7657-comision-septima-del-senado-avanza-en-la-regulacion-de-la-inteligencia-artificial-en-salud
2. U.S. Food and Drug Administration. Clinical Decision Support Software: Guidance for Industry and Food and Drug Administration Staff. Actualización de enero de 2026. https://www.fda.gov/regulatory-information/search-fda-guidance-documents/clinical-decision-support-software
3. Lee YS, Youn BY. Clinical Specialty Expansion of AI-Enabled and Machine Learning-Enabled Medical Devices Authorized by the US Food and Drug Administration From 1995 to 2025: Longitudinal Content Analysis. J Med Internet Res. 2026;28:e103040. doi:10.2196/103040.
4. Patel VR, Finlayson SG, Liu-Hass M, et al. Clinician Use of an Artificial Intelligence–Enabled Clinical Information Platform. JAMA. Publicado en línea el 15 de octubre de 2026. doi:10.1001/jama.2026.21868.
5. Patel H, Crusco S, Hansen D, et al. A Systematic Review and Meta-analysis of Externally Validated Epic Clinical Decision Support Tools. J Gen Intern Med. 2026. doi:10.1007/s11606-026-10381-y.
6. Perets O, Stagno E, Ben Yehuda E, et al. Inherent Bias in Electronic Health Records: A Scoping Review of Sources of Bias. ACM Trans Intell Syst Technol. 2025. doi:10.1145/3757924.
7. Celi LA, Yamamoto R, Fernandes C, et al. The crystal ball problem: why prediction models are not guaranteed to improve health outcomes. npj Artificial Intelligence. Publicado el 19 de octubre de 2026. doi:10.1038/s44387-026-00171-6. [Artículo de perspectiva].
8. Chen D, Blayne A, Ning T, et al. Reporting completeness of clinical trials evaluating large language model interventions in medicine: systematic review. BMJ. 2026;395:e100855. doi:10.1136/bmj-2026-100855.

